
GPT Image 2
openai/gpt-image-2GPT-image-2 是 OpenAI 最新的尖端图像生成模型。主要附加价值包括性能提升、质量提升、编辑控制和面部保护。该模型支持高强度 input_fidelity,并且可以添加或移除图像的某一方面,同时保留其他部分。该模型在宽高比、分辨率和编辑能力方面都有改进。
- 输入 / 输出模态
- 公开起步价格
- 按多项属性定价
- 收录时间
- 2026年4月22日
在线推理
输入配置
控件、可选项与默认值均直接来自当前模型的 API Schema。
任务结果
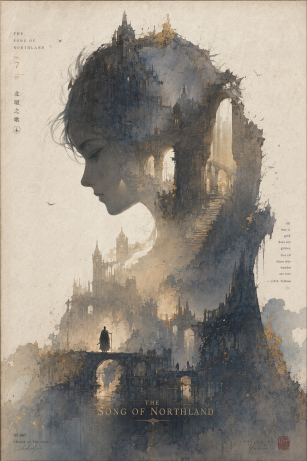
{
"image_urls": [
"https://oss.shengsuanyun.com/example/modelinfo/314/output_1.png?x-oss-process=image/resize,p_30"
],
"progress": 100
}
历史任务
任务历史
仅支持查看最近七个自然日的生成记录。
请登录后查看历史任务。
登录查看历史任务仅显示所选个人账户或企业项目的任务。默认查询当前模型,清空模型名称可查看全部模型。
| 任务 ID | 模型 | 完成状态 | 创建时间 | 耗时 | 消耗模力 | 产物 |
|---|
API 调用
GPT Image 2 的示例代码与 API 说明
Modelmesh 会帮你在不同服务提供商之间规范化处理请求和响应,为你统一接口。
Modelmesh 提供了兼容 OpenAI 的 Completion API,可连接 300 多款模型与服务提供商,既可直接调用,也可通过 OpenAI SDK 调用。此外,还提供了一些第三方 SDK。
在以下示例中,Modelmesh 专用的请求头属于可选项。若你配置了这些请求头,你的应用就能出现在 Modelmesh 的排行榜上。
#!/usr/bin/env bash
set -euo pipefail
API_KEY="$SSY_API_KEY"
curl --fail-with-body --silent --show-error --location \
--request POST \
"https://router.shengsuanyun.com/api/v1/tasks/generations" \
--header "Content-Type: application/json" \
--header "Authorization: Bearer ${API_KEY}" \
--data '{
"model": "openai/gpt-image-2",
"background": "auto",
"moderation": "auto",
"n": 1,
"output_compression": 100,
"prompt": "帮我生成一张图,整体构图需要具有强烈的收藏版海报气质与高级设计感,大结构稳定,主轮廓强烈明确,内部世界具有纵深、秩序和呼吸感,细节丰富但不拥挤,内容丰满但不杂乱,可以适度加入小比例人物剪影、远处建筑、光柱、门洞、桥、阶梯、回廊、倒影、天光或远景结构来增强尺度感、故事感与史诗感。整体画面要安静、宏大、凝练、富有余味,不要平均铺满,不要廉价热闹,不要无重点堆砌。风格融合收藏版电影海报构图、高级叙事型视觉设计、梦幻水彩质感与纸张印刷品气质,强调纸张颗粒感、边缘飞白、水彩刷痕、轻微晕染、空气透视、柔和雾化、局部体积光、光雾穿透、大面积留白与克制版式,让画面看起来像设计师完成的高端收藏版视觉作品,而不是普通 AI 跑图。整体气质要高级、诗意、宏大、神圣、怀旧、安静、具有传说感和叙事感。色彩由 AI 根据主题自动判断并匹配最合适的高级配色方案,但必须保持统一、克制、耐看、低饱和、高级,不要杂乱高饱和,不要廉价霓虹感,不要塑料数码感。配色可以围绕黑金灰、冷蓝灰、雾白灰、褐红米白、暗铜、旧纸色、深海蓝、暮色紫、银灰等体系自由变化,但必须始终服务主题,并保持海报级审美与整体和谐。最终要求:第一眼有强烈的主题识别度和轮廓记忆点,第二眼有完整丰富的叙事世界,第三眼仍有细节和余味。轮廓选择必须具有创意和主题匹配度,尽量避免重复、保守、常见的容器套路,优先选择更有象征性、更有空间感、更有设计潜力的轮廓形式。不要普通背景拼接,不要生硬裁切,不要模板化奇幻素材,不要游戏宣传图感,不要过度卡通化,不要过度写实导致失去艺术感,不要形式大于内容。如果合适,可以自然加入低调克制的标题、编号、签名或落款,让它更像收藏版海报设计的一部分,但不要喧宾夺主。",
"quality": "auto",
"size": "auto"
}'
#!/usr/bin/env bash
set -euo pipefail
API_KEY="$SSY_API_KEY"
REQUEST_ID="${SSY_REQUEST_ID:?Set SSY_REQUEST_ID to the ID returned by task submission}"
curl --fail-with-body --silent --show-error --location \
--request GET \
"https://router.shengsuanyun.com/api/v1/tasks/generations/${REQUEST_ID}" \
--header "Authorization: Bearer ${API_KEY}"
价格
价格明细
主流大模型 API 价格速查(2026 年 10 月)
数据说明:以下价格均整理自各厂商官方定价页面或公开定价文档,单位为美元 / 百万 Token(DeepSeek 人民币价格单独标注)。大模型定价变动频繁,且普遍存在缓存折扣、批处理折扣、长上下文加价等复杂规则,实际费用请以调用时的官方计费为准。
OpenAI
OpenAI 当前主力模型分为三档,旗舰与轻量级价差显著。
| 模型 | 输入价格 | 输出价格 | 备注 |
|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 旗舰,复杂推理与编码 |
| GPT-6.1 Sol | $2.00 | $10.00 | 均衡档 |
| GPT-6 Luna | $0.10 | $0.50 | 高吞吐低成本 |
关键计费规则:GPT-6 Astra 在输入超过 272K tokens 时,整个请求按输入 2 倍、输出 1.5 倍计价;Batch/Flex 模式为标准价的 50%,Fast 模式为 2 倍。
Anthropic Claude
Claude 全系保持“输出 = 输入 × 5”的定价结构,缓存配置较为灵活。
| 模型 | 输入价格 | 输出价格 | 定位 |
|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $50.00 | 旗舰,较慢 |
| Claude Opus 5.5 | $4.00 | $20.00 | 智能体编码与知识工作 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 快速,性价比主力 |
| Claude Haiku 5.5 | $0.10 起 | $0.50 起 | 最快,轻量任务 |
关键计费规则:Opus 5.5 缓存读取 $0.20/MTok,批处理 API 享 50% 折扣。Haiku 5.5 在 prompt 超过 100K tokens 时输入价格从 $0.10 跳升至 $0.50。
Google Gemini
Gemini 定价因模型版本和上下文长度差异较大,以下为代表性价位。Gemini 3 系列 Flash 模型在 $0.50–$0.75 输入区间提供了较强的性价比。
| 模型/场景 | 输入价格 | 输出价格 | 备注 |
|---|---|---|---|
| Gemini 3 Flash 级别 | ~$0.50 | ~$3.00 | 高性价比 Flash 系列 |
| Gemini 3 Pro(≤200K) | $2.00 | $12.00 | 多模态与智能体 |
| Gemini 3 Pro(>200K) | $4.00 | $18.00 | 长上下文翻倍 |
关键计费规则:Gemini 3.1 Pro 在 prompt 超过 200K tokens 时,输入翻倍、输出加价 50%,且加价适用于整个请求而非仅超出部分。
DeepSeek
DeepSeek 以人民币计价,并采用峰谷定价:空闲时段价格为高峰时段的一半。高峰时段为北京时间周一至周五 9:00–12:00、14:00–18:00(不含法定节假日)。
| 模型 | 场景 | 输入(缓存未命中) | 输出 |
|---|---|---|---|
| DeepSeek Flash | 空闲 | ¥1.00 | ¥4.00 |
| DeepSeek Flash | 高峰 | ¥2.00 | ¥8.00 |
| DeepSeek V4 Pro | 空闲 | ¥4.50 | ¥13.50 |
| DeepSeek V4 Pro | 高峰 | ¥9.00 | ¥27.00 |
关键优势:DeepSeek 的 1M 上下文不收取长上下文附加费,所有 token 均按统一费率计费。缓存命中输入低至 ¥0.02–¥0.30/MTok(视峰谷与模型而定)。
Kimi(月之暗面)
Kimi K3 系列均支持约 1M tokens 上下文,缓存命中享有大幅折扣。
| 模型 | 输入价格 | 输出价格 | 缓存命中输入 |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
| kimi-k3 | $3.00 | $15.00 | $0.30 |
注意:K2 系列计划于 2026 年 12 月底下线,新用户自 2026 年 10 月 31 日起不再开放注册。
阿里云百炼 Qwen
Qwen 系列型号繁多,以下选取代表性档位(国际站美元价)。
| 模型 | 输入价格(≤256K) | 输出价格 | 备注 |
|---|---|---|---|
| qwen3.7-plus | 原价 $0.40(限时 8 折) | 原价 $1.60(限时 8 折) | 均衡档 |
| qwen3.8-flash | $0.113 | $0.382 | 轻量低成本 |
| qwen-flash | $0.022–$0.15 | $0.216–$1.50 | 视上下文长度阶梯定价 |
Qwen 的定价因部署地域(北京、新加坡、东京、法兰克福等)和上下文区间存在差异,上表仅为部分档位参考。
快速选型参考
| 需求场景 | 可优先考虑 | 理由 |
|---|---|---|
| 最强推理 / 编码 | GPT-6 Astra、Claude Fable 5.1 | 旗舰能力,价格最高 |
| 性价比主力 | Claude Sonnet 5.5、GPT-6.1 Sol、Kimi K3.1 Pro | $2/$10 档位,能力与成本均衡 |
| 极致低价 / 高吞吐 | GPT-6 Luna、Claude Haiku 5.5、DeepSeek Flash | 输入 $0.1 级别或更低 |
| 长上下文且不想被加价 | DeepSeek、Claude 4.6+ 大模型 | 1M 上下文统一费率,无长上下文附加费 |
| 缓存密集型工作负载 | Claude(缓存配置最细)、DeepSeek(缓存折扣大) | 缓存读取成本远低于常规输入 |
最后提醒:以上价格未包含批处理折扣、优先处理加价、工具调用(搜索/代码执行)等附加费用。生产环境选型前,建议用实际业务的 token 分布做一轮成本测算,并关注各厂商的限时折扣与峰谷规则。
精益评测
<details>
<summary>点击这里展开/折叠标题</summary>
这里是被折叠的内容。
你可以在这里写普通的 Markdown 格式,比如 加粗、列表等。
</details>